Bảng mã hóa biến (codebook) là gì? Cách lập từng bước, có ví dụ
Codebook là bảng giải thích từng biến trong tệp dữ liệu: tên biến, nhãn, loại, giá trị mã, mã cho dữ liệu thiếu. Bài hướng dẫn lập từng bước, có bảng mẫu 14 biến cho nghiên cứu tăng huyết áp và cách đặt tên biến để SPSS, Stata không báo lỗi.

TS.BS. Vũ Duy Kiên
Mục lục
Ba tháng sau khi nhập liệu, bạn mở lại tệp Excel: cột “sex” lẫn lộn 1, 2, “Nam”, “nữ”; cột “diabetes” có số 0 mà bạn không nhớ là “không mắc” hay “không có thông tin”. Bảng mã hóa biến, hay codebook, ngăn chuyện đó xảy ra.
Bảng mã hóa biến (codebook) là gì
Codebook là tài liệu mô tả từng biến có trong tệp dữ liệu của nghiên cứu [1]. Nhờ nó, bạn và bất kỳ ai mở tệp đều đọc ra cùng một nghĩa cho từng cột và từng con số. Codebook và từ điển dữ liệu (data dictionary) cho biết nhiều điều về biến và cách thu thập dữ liệu, giúp dữ liệu dùng lại được [8] (chỉ đọc tóm tắt); hai từ này hay dùng thay nhau, bài này dùng “codebook”.
Codebook không phải phiếu thu thập số liệu: phiếu dùng để hỏi người bệnh hay trích hồ sơ, còn codebook chú giải tệp dữ liệu. Nên lập trước khi nhập liệu để người nhập có sẵn quy ước. Phiếu quyết định thu những gì; codebook quyết định mỗi thứ thu được nhập và đọc ra sao. Cách làm phiếu ở bài Phiếu thu thập số liệu / bệnh án nghiên cứu.
Codebook gồm những cột nào
Hướng dẫn của một kho lưu trữ dữ liệu yêu cầu mỗi biến có [1]: tên biến không mơ hồ; nhãn (mô tả bằng chữ hoặc chỉ rõ câu tương ứng trên công cụ thu thập); loại dữ liệu (số, chữ, ngày); với biến phân loại, các giá trị hợp lệ kèm nhãn; mã cho dữ liệu thiếu hoặc không áp dụng kèm ý nghĩa; với biến suy ra, cách tính.
Từ điển dữ liệu theo Broman và Woo còn có đơn vị đo và giá trị nhỏ nhất, lớn nhất dự kiến [2]. Bảng mẫu dưới đây dùng chín cột, theo mẫu tôi dùng khi hướng dẫn: STT · Variable (tên biến) · Label (nhãn) · Role (vai trò) · Type (loại) · Coding/Unit (mã hoặc đơn vị, kèm mã thiếu) · Source (nguồn) · Time (thời điểm đo) · Validation (quy tắc kiểm tra). Cột Role cho biết biến là kết cục (Outcome), yếu tố liên quan (Predictor), biến nền (Covariate), biến hành chính (Administrative) hay biến tính ra (Derived). Codebook đầy đủ còn có thể thêm các trường như mục tiêu liên quan, định nghĩa khái niệm và định nghĩa hoạt động, logic bỏ qua, công thức biến tính ra (khoảng 20 trường); bài này giữ chín cột cho gọn.
Ví dụ từ đầu đến cuối: nghiên cứu tuân thủ điều trị tăng huyết áp
Giả sử bạn làm nghiên cứu cắt ngang về tuân thủ điều trị ở người bệnh tăng huyết áp tại một phòng khám ngoại trú (ví dụ giả định, không phải nghiên cứu thật). Quần thể mục tiêu là người bệnh tăng huyết áp điều trị ngoại trú; quần thể nghiên cứu là những người đủ tiêu chuẩn tại phòng khám đó trong thời gian nghiên cứu. Điểm xuất phát là bảng biến số trong phần Phương pháp (cách viết).
Bước 1. Liệt kê biến theo mục tiêu: biến kết cục (tuân thủ), yếu tố có thể liên quan (hút thuốc, đái tháo đường, số thuốc, học vấn, huyết áp, BMI) và biến nền (tuổi, giới).
Bước 2. Chọn loại: hai nhóm là nhị phân; nhiều nhóm không thứ tự là danh định; có thứ tự là thứ hạng; đo bằng số là định lượng. Tách biến nhập với biến tính ra như BMI.
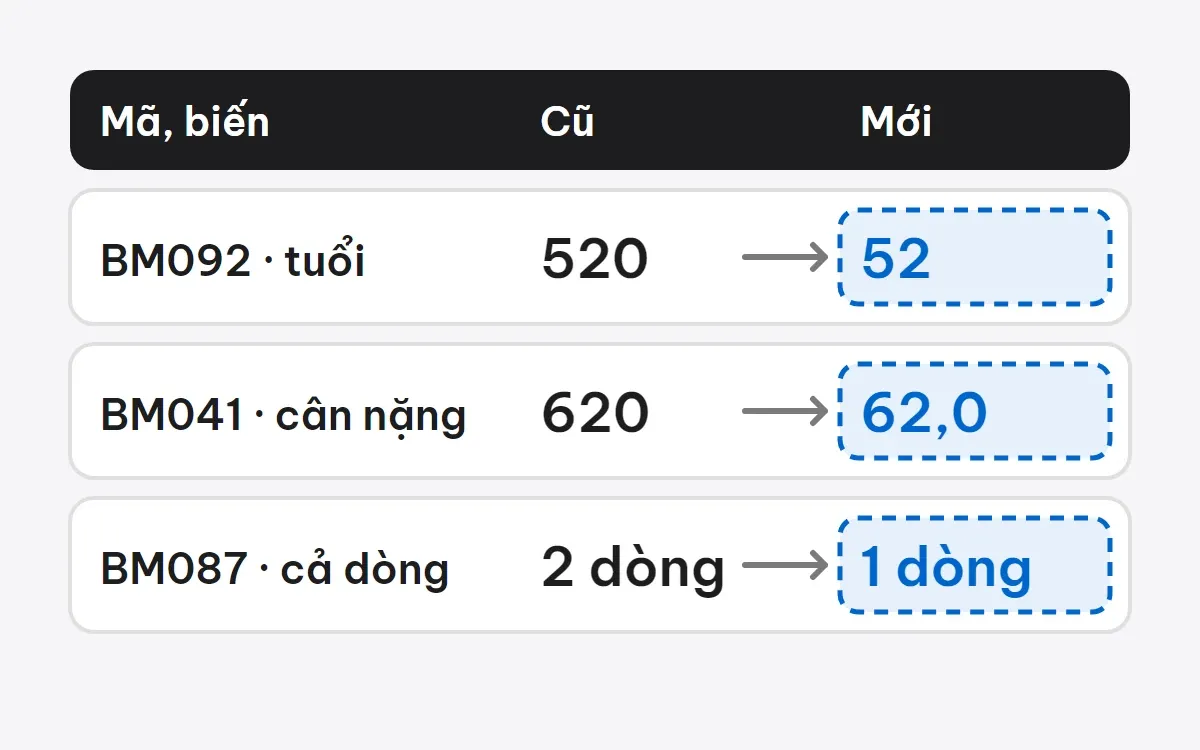
Bước 3. Định mã, đơn vị, khoảng hợp lý. Biến phân loại nhận mã số, mỗi mã một nhãn. Biến định lượng ghi đơn vị, số chữ số thập phân và khoảng hợp lý đặt trước, vì làm sạch số liệu cần quy tắc xử lý lỗi định sẵn [4]. Các khoảng trong bảng do tôi đặt cho ví dụ, không phải chuẩn; bạn phải tự quyết và nêu căn cứ. Quy tắc kiểm tra có hai mức: hard cho giá trị bất khả thi (tuổi 520; chiều cao 1,75 ở cột đơn vị cm) và soft cho giá trị hiếm nhưng có thể xảy ra (creatinine rất cao). Hard thì mở phiếu gốc xác nhận rồi sửa; soft thì chỉ đánh dấu để xem lại, đừng loại. Đừng đặt khoảng quá hẹp theo giá trị “bình thường”.
Bước 4. Quy ước mã thiếu. Biến phân loại: 97 = không áp dụng, 98 = từ chối trả lời, 99 = không rõ hoặc không ghi nhận. Biến định lượng (tuổi, huyết áp, cân nặng…): 997, 998, 999 cùng nghĩa, nằm ngoài khoảng hợp lệ. Cả hai nhóm chỉ để nhập; phải chuyển thành giá trị thiếu (missing) trước khi phân tích (lý do ở mục “Mã cho dữ liệu thiếu”).
Bước 5. Lập bảng. Mỗi biến một dòng; ở cột Coding/Unit chỉ ghi các mã thiếu mà biến đó thật sự dùng.
| STT | Variable | Label | Role | Type | Coding/Unit | Source | Time | Validation |
|---|---|---|---|---|---|---|---|---|
| 1 | study_id | Mã nghiên cứu của người bệnh | Administrative | Chữ (định danh) | BN001 đến BN150, không trùng | Phiếu | Lúc tuyển | Không trùng, không thiếu; họ tên và số hồ sơ để riêng |
| 2 | visit_date | Ngày khám | Administrative | Ngày | AAAA-MM-DD, như 2026-03-02; thiếu thì để trống, không dùng ngày giả | Hồ sơ khám | Lúc tuyển | Không thiếu |
| 3 | age | Tuổi | Covariate | Số, rời rạc | Năm tròn; 997, 998, 999 | Phiếu, câu A1 | Lúc khám | Hard: 18 đến 100 (theo tiêu chuẩn chọn của ví dụ) |
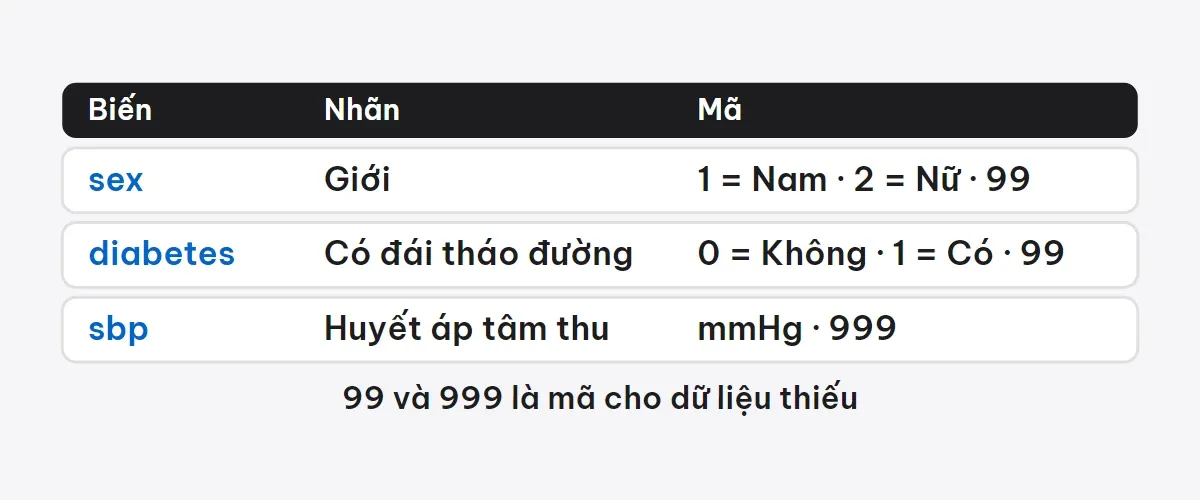
| 4 | sex | Giới | Covariate | Phân loại, nhị phân | 1 = Nam; 2 = Nữ; 99 | Phiếu, câu A2 | Lúc khám | Chỉ nhận 1, 2, 99 |
| 5 | education | Học vấn cao nhất | Covariate | Phân loại, thứ hạng | 1 = Tiểu học trở xuống; 2 = THCS; 3 = THPT; 4 = Trung cấp, cao đẳng; 5 = Đại học trở lên; 98; 99 | Phiếu, câu A3 | Lúc khám | Chỉ nhận 1 đến 5, 98, 99 |
| 6 | smoking_status | Hút thuốc lá | Predictor | Phân loại, danh định | 0 = Chưa bao giờ; 1 = Đã bỏ; 2 = Đang hút; 98; 99 | Phiếu, câu B1 | Lúc khám | Chỉ nhận 0 đến 2, 98, 99 |
| 7 | smoking_years | Số năm đã hút | Predictor | Số, rời rạc | Năm; 997 nếu smoking_status = 0; 999 | Phiếu, câu B2 | Lúc khám | Hard: 1 đến 70; nếu smoking_status = 0 thì phải là 997 |
| 8 | diabetes | Có đái tháo đường | Predictor | Phân loại, nhị phân | 0 = Không; 1 = Có; 99 = hồ sơ không ghi | Hồ sơ khám | Lúc khám | Chỉ nhận 0, 1, 99 |
| 9 | weight_kg | Cân nặng | Covariate | Số, liên tục | kg, 1 chữ số thập phân; 999 | Đo tại phòng khám | Lúc khám | Hard: 30,0 đến 200,0 |
| 10 | height_cm | Chiều cao | Covariate | Số, liên tục | cm; 999 | Đo tại phòng khám | Lúc khám | Hard: 120 đến 210 |
| 11 | bmi | BMI | Derived | Số, tính ra | kg/m², weight_kg / (height_cm / 100)², 1 chữ số thập phân; 999 nếu thiếu biến gốc | Phần mềm tính | Lúc khám | Soft: ngoài 15 đến 50 thì xem lại hai biến gốc |
| 12 | sbp | Huyết áp tâm thu | Predictor | Số, liên tục | mmHg; 999 | Theo quy trình đo | Lúc khám | Hard: 60 đến 300 |
| 13 | n_antihyp | Số loại thuốc hạ huyết áp | Predictor | Số, rời rạc | Số loại; 999 | Đơn thuốc hiện tại | Lúc khám | Hard: 0 đến 10 |
| 14 | adherence | Tuân thủ điều trị (biến chính) | Outcome | Phân loại, nhị phân | 0 = Không; 1 = Có, theo điểm cắt của [tên thang]; 99 nếu thiếu câu để tính điểm | Tính từ [tên thang] | Lúc khám | Chỉ nhận 0, 1, 99 |
BMI là biến suy ra; theo WHO, đó là cân nặng (kg) chia cho bình phương chiều cao (m) [9]. Ghi công thức vào codebook để người khác tính lại được [1].
Bảng trên theo cấu trúc mẫu codebook tôi dùng khi hướng dẫn. Với đề tài thật, bạn bổ sung cho mỗi biến định nghĩa hoạt động, quy tắc thiếu, logic bỏ qua và thời điểm đo chi tiết hơn.
Định nghĩa hoạt động. “Có đái tháo đường” (diabetes) chưa đủ: phải nói dựa vào tiền sử trong hồ sơ, thuốc đang dùng hay xét nghiệm. Ví dụ giả định: diabetes = 1 khi hồ sơ ghi chẩn đoán đái tháo đường hoặc người bệnh đang dùng thuốc hạ đường huyết; 0 khi hồ sơ ghi không có; 99 khi hồ sơ không đề cập. Hồ sơ không đề cập không có nghĩa là không mắc.
Bước 6. Thử vài phiếu trước khi nhập hàng loạt. Năm dòng nhập thử (dữ liệu giả):
| study_id | visit_date | age | sex | education | smoking_status | smoking_years | diabetes | sbp |
|---|---|---|---|---|---|---|---|---|
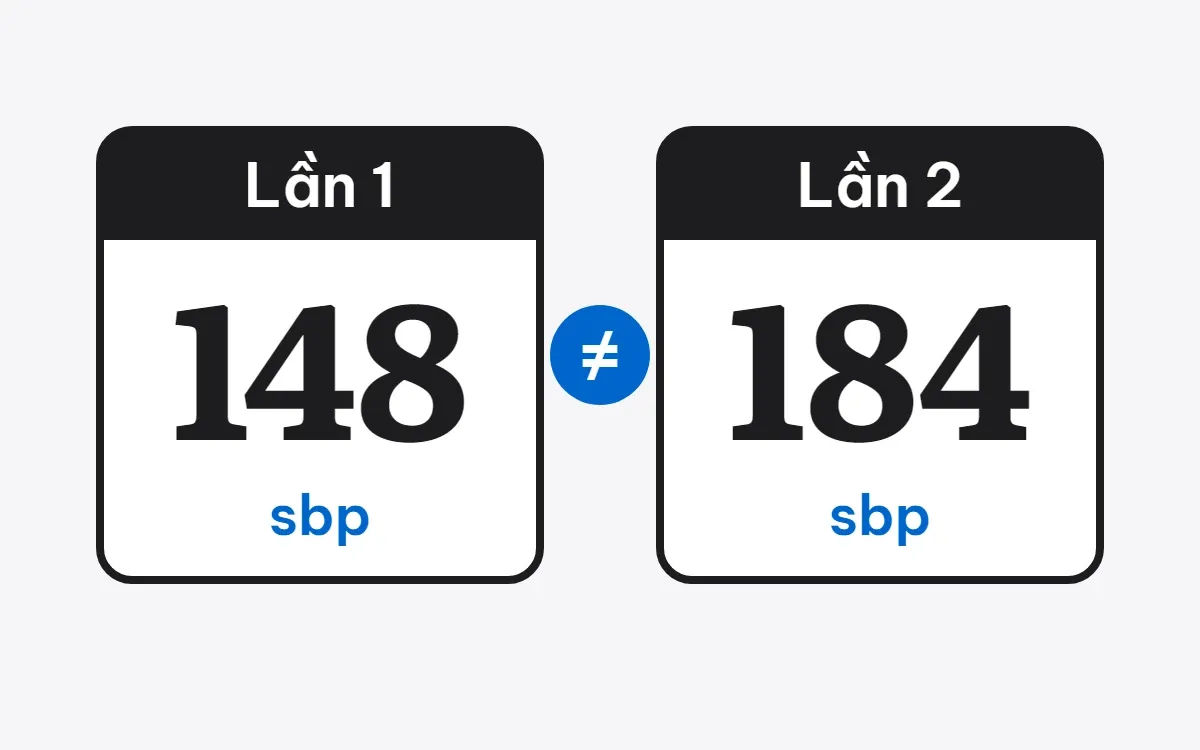
| BN001 | 2026-03-02 | 63 | 2 | 2 | 0 | 997 | 1 | 148 |
| BN002 | 2026-03-02 | 58 | 1 | 3 | 2 | 20 | 0 | 162 |
| BN003 | 2026-03-03 | 520 | 1 | 99 | 1 | 15 | 99 | 135 |
| BN004 | 2026-03-03 | 71 | 2 | 1 | 0 | 12 | 0 | 999 |
| BN005 | 2026-03-04 | 66 | 3 | 2 | 0 | 997 | 0 | 152 |
Đối chiếu với codebook, bạn bắt được ba lỗi:
- BN003, age = 520. Vi phạm quy tắc hard: ngoài khoảng 18 đến 100. Có thể là 52 gõ thừa số 0, nhưng đừng tự sửa: mở phiếu gốc xác nhận [4].
- BN004, smoking_status = 0 nhưng smoking_years = 12. Hai biến mâu thuẫn; xem lại phiếu.
- BN005, sex = 3. Mã 3 không có trong codebook.
Ba chỗ không phải lỗi: education = 99 và diabetes = 99 ở BN003, sbp = 999 ở BN004 là “không rõ” đã khai báo; smoking_years = 997 là “không áp dụng” vì người đó chưa từng hút thuốc. Trước khi phân tích, các mã 99, 997, 999 này phải chuyển thành missing.
Nhập thử xong và sửa codebook, hãy khóa nó ở bản v1.0 (ghi ngày); các bản nháp trước là v0.1, v0.2. Mọi thay đổi sau đó làm đổi cách hiểu dữ liệu đều ghi vào một change log.
Mã hóa giới, ngày tháng và biến có/không
Chọn một quy ước và dùng thống nhất: ví dụ trên dùng 1 = Nam, 2 = Nữ và 0 = Không, 1 = Có; ghi vào codebook, không đổi giữa chừng. Mỗi ô chỉ một thông tin: ghi 45 chứ không phải “45 g” [2]. Ngày tháng dùng AAAA-MM-DD theo ISO 8601, vì 02/03/2026 có thể đọc là 2 tháng 3 hoặc 3 tháng 2 [2]. Phiếu giấy có thể vẫn in dd/mm/yyyy cho người điền quen; khi nhập vào tệp thì đổi sang AAAA-MM-DD. Đừng dùng ngày giả (như 1900-01-01 hay chuỗi toàn số 9) để biểu diễn ngày thiếu: để trống (missing) và ghi lý do ở biến riêng. Cách làm phiếu: xem bài phiếu thu thập số liệu.
Giữ biến gốc khi gộp nhóm
Khi cần gộp, tạo biến mới và giữ nguyên biến gốc, không ghi đè. Ví dụ smoking_status có ba mức (0 chưa bao giờ, 1 đã bỏ, 2 đang hút); nếu phân tích cần so sánh người đang hút với còn lại, tạo thêm current_smoker (1 khi smoking_status = 2; 0 khi là 0 hoặc 1) và giữ cả hai. Câu hỏi chọn nhiều đáp án thì mỗi đáp án một biến 0/1 (như hx_htn, hx_dm cho tiền sử tăng huyết áp, đái tháo đường), không nhét nhiều giá trị vào một ô; lựa chọn “Khác” thêm biến _other để ghi chữ. Biến đo ở nhiều thời điểm hoặc hai bên cơ thể thêm hậu tố: sbp_baseline, sbp_week4, bp_left, bp_right. Khi báo cáo tỷ lệ của một biến, mẫu số là số người có dữ liệu hợp lệ cho biến đó (sau khi đã chuyển mã thiếu thành missing), trừ khi đề cương quy định khác.
Mã cho dữ liệu thiếu
Dữ liệu thiếu là giá trị không có sẵn nhưng lẽ ra có ý nghĩa cho phân tích nếu quan sát được [3]. Bốn điều đáng làm từ đầu:
Ghi lý do thiếu. Người bệnh từ chối khác với hồ sơ không ghi; biết lý do giúp đặt giả định hợp lý khi xử lý về sau [3]. Stata có sẵn 27 giá trị thiếu (dấu chấm và .a đến .z), một số người dùng chúng để phân biệt lý do [6]. Mã số như 97, 98, 99 làm được việc đó ở mọi phần mềm. Cách khác: để ô thiếu thật (NA) và thêm một biến ghi lý do thiếu (ví dụ smoking_years_missing_reason); cách này tránh được rủi ro mã bị tính như số thật, nhưng thêm một cột.
Mã nằm ngoài giá trị có thể có. Đừng dùng 0 cho “không có thông tin”: 0 là số thật ở nhiều biến (số thuốc). Mã 99 cũng nguy hiểm với biến định lượng, vì người 99 tuổi là có thật. Vì vậy bài dùng hai bộ mã: biến phân loại dùng 97 (không áp dụng), 98 (từ chối), 99 (không rõ); biến định lượng như tuổi, huyết áp, cân nặng dùng 997, 998, 999 cùng nghĩa, nằm ngoài khoảng hợp lệ (tuổi hợp lệ từ 18 đến 100 thì 997 không thể là tuổi thật). Đây là quy ước của bài, không phải chuẩn; điều cần là mỗi mã thiếu được định nghĩa trong codebook [1].
Chuyển thành missing trước khi phân tích. Các mã 97, 98, 99 và 997, 998, 999 chỉ để nhập và đọc. Trước khi tính trung bình, hồi quy hay lập bảng, phải chuyển chúng thành giá trị thiếu của phần mềm; nếu không, huyết áp “999” sẽ kéo trung bình lên như một số đo thật. Ghi bước chuyển này vào codebook và vào quy trình phân tích.
“Không áp dụng” khác “thiếu”. Người chưa từng hút thuốc không có số năm hút; giá trị đó không tồn tại để mà thiếu. Theo cách hiểu của tôi, nên cho nó mã riêng (997 cho biến số, 97 cho biến phân loại) thay vì gộp với “không rõ”.
Broman và Woo khuyên không để ô trống mà điền một mã chung như “NA” hoặc dấu gạch, để thấy thiếu có chủ ý chứ không phải quên [2]. Chọn một cách, ghi vào codebook, và thử nạp vài dòng vào phần mềm phân tích trước.
Đặt tên biến để SPSS và Stata không báo lỗi
Stata cho tên dài 1 đến 32 ký tự gồm chữ, số, gạch dưới; ký tự đầu là chữ hoặc gạch dưới; phân biệt hoa thường (myvar, Myvar, MYVAR là ba biến) [5]. SPSS cho tối đa 64 byte, ký tự đầu là chữ hoặc @, # hay $, không khoảng trắng, không bắt đầu hoặc kết thúc bằng dấu chấm [7]. Để tên dùng được ở cả hai nơi, theo quy tắc hẹp hơn:
- Chữ thường, không dấu, không khoảng trắng, nối bằng gạch dưới:
smoking_status, không phải “Hút thuốc”. Bài dùng tên tiếng Anh ngắn nhưage,sex,sbp(nhãn mô tả vẫn viết tiếng Việt); bạn có thể đặt tên tiếng Việt không dấu nếu cả nhóm thống nhất. Khoảng trắng làm việc viết lệnh khó hơn [2]; không dấu là khuyến nghị của tôi để tránh lỗi mã hóa chữ. - Bắt đầu bằng chữ cái, tối đa 32 ký tự (mức nhỏ hơn trong hai giới hạn [5, 7]). Stata khuyên không bắt đầu bằng gạch dưới vì biến có sẵn của nó bắt đầu như vậy [5].
- Tránh ký tự đặc biệt như $ @ % # & * ( ) ! / [2] và từ dành riêng. SPSS không cho dùng ALL, AND, BY, EQ, GE, GT, LE, LT, NE, NOT, OR, TO, WITH [7]; Stata dành riêng các tên như in, if, int, long, float, double, byte, using, with, all [5].
- Ngắn nhưng có nghĩa:
age,sbpđọc ra ngay;x1,var3thì không [2]. Đơn vị đặt trong tên (weight_kg) hoặc, tốt hơn, trong codebook [2].
Lỗi hay gặp khi lập codebook
- Lập sau khi nhập xong, khi mỗi người nhập đã một kiểu.
- Dùng 0 hay ô trống cho dữ liệu thiếu: không phân biệt được “không có” với “không biết”.
- Đổi mã giữa chừng mà không ghi lại.
- Để họ tên, số điện thoại, số hồ sơ trong tệp phân tích. Định danh trực tiếp như tên, số điện thoại, số hồ sơ bệnh án phải loại khỏi tệp khi chia sẻ [1]. Dùng mã nghiên cứu, giữ bảng đối chiếu ở nơi riêng.
- Không đặt khoảng hợp lý, nên lỗi như tuổi 520 lọt tới khâu phân tích [4].
- Quên chuyển mã thiếu thành missing: 999 vào phép tính trung bình như một số đo thật.
- Không khóa phiên bản codebook, nên không biết tệp dữ liệu nào dùng bản nào.
Checklist codebook
- Mỗi cột của tệp dữ liệu có một dòng trong codebook, tên khớp từng ký tự.
- Mỗi biến có nhãn, loại, giá trị mã (hoặc đơn vị, khoảng hợp lý), mã thiếu.
- Mỗi mã thiếu có định nghĩa; không dùng 0 hay ô trống thay cho thiếu; mã thiếu đã được chuyển thành missing trước khi phân tích.
- Biến tính ra có công thức; ngày dạng AAAA-MM-DD; tên biến không dấu, không khoảng trắng.
- Biến gộp nhóm không ghi đè biến gốc; có phân biệt hard và soft trong quy tắc kiểm tra.
- Codebook ghi phiên bản (v1.0) và ngày; có change log.
- Đã thử nhập vài phiếu và đối chiếu với codebook.
- Họ tên, số điện thoại, số hồ sơ không nằm trong tệp phân tích.
Hiểu codebook như vậy là đủ
Codebook là bản chú giải của tệp dữ liệu. Lập trước khi nhập liệu, định nghĩa từng mã thiếu, đặt khoảng hợp lý và tên biến theo luật chung của phần mềm bạn dùng, để ba tháng sau ai mở tệp cũng đọc ra cùng một nghĩa.
Đọc tiếp
Bảng biến số trong đề cương là nguyên liệu của codebook: xem cách viết phần Phương pháp. Nếu bộ câu hỏi là thang đo, xem Cronbach’s alpha là gì.
Bước trước codebook là phiếu thu thập số liệu; bước sau là nhập liệu và nhập liệu kép, nơi bạn dùng codebook này để dựng form và đặt luật kiểm tra. Muốn học bài bản từ đề cương đến báo cáo, xem thêm ở mục Khóa học.