Làm sạch số liệu trước khi phân tích: 6 kiểm tra và cách ghi nhật ký sửa
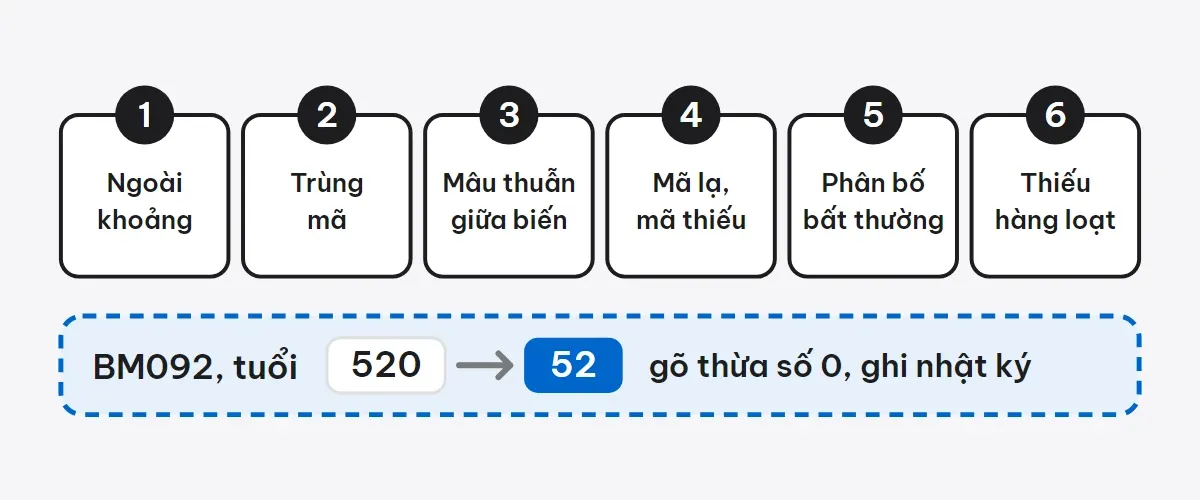
Nhập xong số liệu rồi, có chạy phân tích ngay được không? Chưa. Bài này đưa 6 kiểm tra (ngoài khoảng, trùng mã, mâu thuẫn ngày, mã lạ, phân bố bất thường, thiếu hàng loạt), cách xử lý giá trị lạ và một nhật ký làm sạch mẫu 5 dòng.

TS.BS. Vũ Duy Kiên
Mục lục
Bạn vừa nhập xong 150 phiếu. File số liệu nằm đó, đẹp đẽ, đủ dòng đủ cột. Tay bạn đã đặt lên chuột, sẵn sàng bấm chạy phân tích. Khoan đã.
Số liệu vừa nhập xong gần như chưa bao giờ sạch. Luật kiểm tra lúc nhập chặn được nhiều lỗi, nhưng không chặn hết. Có lỗi lọt qua vì người nhập đã tắt cảnh báo cho đỡ phiền. Có lỗi vốn nằm sẵn trên phiếu giấy. Bạn chạy phân tích luôn thì những con số lạ ấy đi thẳng vào kết quả. Mà bạn không biết.
Bài này giúp bạn kiểm bộ số liệu bằng 6 kiểm tra, quyết định sửa hay giữ từng giá trị lạ, và ghi lại mọi thay đổi trong một nhật ký. Ví dụ xuyên suốt là một nghiên cứu tăng huyết áp 150 bệnh nhân ở một bệnh viện tỉnh. Phần thực hành tôi làm bằng SPSS. Phần nguyên tắc dùng được cho Excel, R hay Stata.
Làm sạch số liệu là gì, và không phải là gì
Làm sạch số liệu (data cleaning) là quá trình phát hiện, chẩn đoán và sửa những số liệu có vấn đề. Đó là cách một nhóm tác giả trong tạp chí PLoS Medicine gọi tên quá trình này [1]. Họ chia nó thành ba bước:
- Phát hiện (screening): bạn chủ động tìm giá trị đáng ngờ. Bạn xem bảng thống kê, vẽ biểu đồ, kiểm khoảng và kiểm sự nhất quán giữa các biến.
- Chẩn đoán (diagnosing): với mỗi giá trị đáng ngờ, bạn hỏi nó là gì. Có bốn khả năng: lỗi, giá trị cực đoan nhưng có thật, giá trị bình thường (bạn đã đoán sai trước đó), hoặc chưa rõ nguyên nhân [1].
- Sửa (editing): chỉ sau khi chẩn đoán, bạn mới quyết định sửa, xóa hay để nguyên [1].
Để ý thứ tự: sửa đứng cuối cùng. Nhiều bạn nhảy thẳng từ “thấy số lạ” sang “xóa”. Đó chính là chỗ làm sạch biến thành “sửa cho đẹp”.
Số lạ cũng chưa chắc sai. Creatinine máu 780 µmol/L nghe rất cao. Nhưng ở bệnh nhân tăng huyết áp có bệnh thận mạn giai đoạn cuối, đó có thể là kết quả thật. Xóa nó đi là bạn xóa đúng nhóm bệnh nhân nặng nhất của nghiên cứu.
Vì vậy nhóm tác giả trên phân biệt hai loại ngưỡng [1]:
- Ngưỡng cứng (hard cutoff): giá trị vượt ngưỡng là không thể xảy ra. Tuổi 520 là ví dụ. Loại này gần như chắc chắn là lỗi.
- Ngưỡng mềm (soft cutoff): giá trị vượt ngưỡng là hiếm, đáng ngờ, nhưng có thể thật. Tuổi 105 là ví dụ. Loại này bạn phải kiểm chứng.
Còn một loại lỗi khó nhất: lỗi nằm gọn trong khoảng hợp lý. Nhóm tác giả gọi là “erroneous inliers”, tức giá trị sai nhưng trông vẫn bình thường [1]. Huyết áp 148 bị nhập thành 184 là ví dụ. Không luật khoảng nào bắt được. Loại này chỉ bắt được nhờ nhập liệu kép, mà bạn có thể xem lại ở bài về nhập liệu.
Ba nguyên tắc trước khi bạn sửa bất kỳ dòng nào
Một: giữ nguyên bản gốc. File số liệu thô vừa nhập xong là bằng chứng ban đầu. Bạn sao nó ra một bản làm việc, đặt tên rõ như clean_v1, rồi mới làm sạch trên bản sao. File gốc bạn để yên, tốt nhất là khóa quyền chỉ đọc. Sau này có ai hỏi “con số này từ đâu ra”, bạn còn đường quay lại.
Hai: sửa theo phiếu gốc, không sửa theo trí nhớ hay phỏng đoán. Thấy tuổi 520, bạn đừng tự nghĩ “chắc là 52”. Bạn lấy phiếu giấy ra xem. Phiếu ghi 52 thì sửa thành 52. Phiếu mờ, phiếu để trống, không ai xác minh được, thì bạn không đoán. Bạn đặt giá trị đó thành “thiếu”, gắn cờ, và ghi lý do. Nhóm tác giả trên cũng viết rằng giá trị không thể xảy ra thì không bao giờ được để nguyên: sửa nếu tìm được giá trị đúng, nếu không thì xóa giá trị đó [1]. Tôi hiểu “xóa” ở đây là xóa giá trị, không phải xóa cả phiếu của người bệnh.
Ba: mọi thay đổi đều để lại dấu vết. Cùng nhóm tác giả đó đề nghị mỗi giá trị bị sửa đều có tài liệu: loại nghi vấn, thông tin chẩn đoán, kiểu sửa, ngày và người thực hiện [1]. Phần dưới của bài có một nhật ký mẫu cho bạn dùng.
Thêm một việc nên làm sớm: đặt ngưỡng cứng và ngưỡng mềm trước khi nhìn số liệu, ghi vào codebook cùng khoảng hợp lệ. Như vậy “giá trị nào lạ” được quyết định bằng quy tắc, không bằng cảm giác lúc đó.
Bộ số liệu dùng làm ví dụ
Để bạn dễ theo dõi, tôi dùng lại nghiên cứu tăng huyết áp trong bài về nhập liệu. Có 150 phiếu, mã từ BM001 đến BM150. Các biến gồm: study_id, age_years (tuổi), sex (1 là nam, 2 là nữ), weight_kg, sbp (huyết áp tâm thu), creatinine (µmol/L), n_bp_drugs (số thuốc hạ huyết áp), adherence (tuân thủ điều trị, 0 hoặc 1, chỉ hỏi người đang dùng thuốc), smoking (0 không, 1 từng, 2 đang hút), cigs_per_day (số điếu mỗi ngày), date_adm (ngày nhập viện), date_dis (ngày ra viện), province.
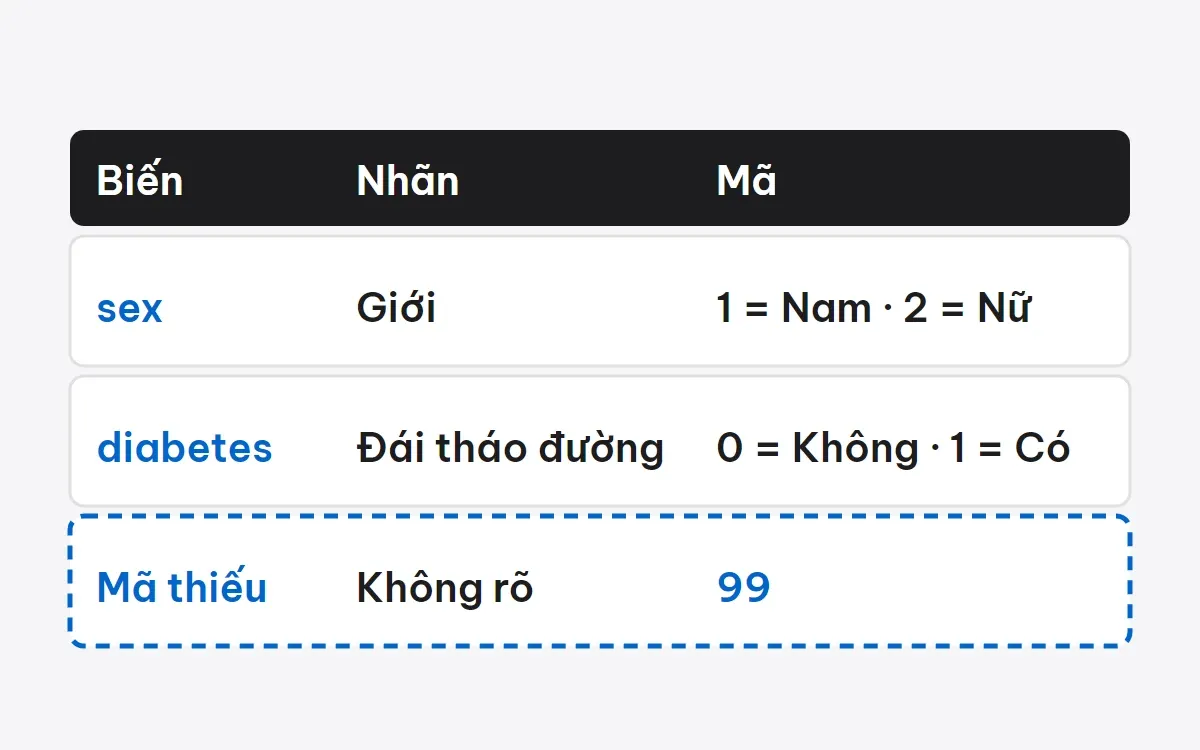
Mã thiếu vẫn theo quy ước các bài trước. Biến phân loại thiếu thì ghi 97, 98, 99. Biến định lượng thiếu thì ghi 997, 998, 999. Bạn ghi nghĩa từng mã vào codebook, ví dụ 997 là không làm xét nghiệm, 998 là không áp dụng, 999 là không biết hoặc phiếu để trống.
Mọi con số và bệnh nhân trong bài là giả định để minh họa. Ngưỡng trong bảng dưới cũng chỉ là ví dụ. Với nghiên cứu của bạn, bạn bàn ngưỡng với bác sĩ lâm sàng trong nhóm.
| Biến | Ngưỡng cứng (không thể) | Ngưỡng mềm (đáng ngờ) |
|---|---|---|
age_years |
dưới 18 (trái tiêu chuẩn chọn) hoặc trên 120 | trên 100 |
weight_kg |
dưới 25 hoặc trên 250 | trên 150 |
sbp |
dưới 50 hoặc trên 300 | dưới 80 hoặc trên 220 |
creatinine |
dưới 10 hoặc trên 3.000 | trên 500 |
Sáu kiểm tra
Trước hết là một bước chuẩn bị rất nhanh: kiểm cấu trúc. Bạn đếm số dòng, số cột, xem mỗi biến được phần mềm hiểu là số hay chữ. Bộ ví dụ của tôi có 151 dòng, trong khi chỉ có 150 phiếu. Ngay đó bạn đã biết có chuyện. Một lỗi hay gặp khác: mã kiểu 0075 bị đọc thành số 75, mất số 0 đầu.
Bảng dưới tóm tắt sáu kiểm tra. Mỗi kiểm tra có phần giải thích ngay sau đó.
| # | Kiểm tra | Câu hỏi | Công cụ SPSS | Lỗi trong ví dụ |
|---|---|---|---|---|
| 1 | Ngoài khoảng | Có giá trị không thể hoặc đáng ngờ không? | Descriptives | Tuổi 520, cân nặng 620 kg |
| 2 | Trùng mã | Có mã nào xuất hiện hai lần không? | Identify Duplicate Cases | BM087 hai dòng |
| 3 | Mâu thuẫn giữa biến | Các biến có “nói” cùng một chuyện không? | Biến mới tự tính, bảng chéo | Ra viện trước nhập viện |
| 4 | Mã lạ, mã thiếu | Có mã nào ngoài codebook không? | Frequencies | sex = 7, tuổi 999 |
| 5 | Phân bố bất thường | Hình dạng phân bố có hợp lý không? | Histogram, boxplot | Creatinine hai đơn vị |
| 6 | Thiếu hàng loạt | Thiếu ở đâu, thiếu vì sao? | Frequencies theo biến, theo nơi | 25% thiếu creatinine |
Kiểm tra 1: Giá trị ngoài khoảng
Đây là kiểm tra quen thuộc nhất. Trong SPSS, bạn vào Analyze > Descriptive Statistics > Descriptives. Bảng kết quả cho cỡ mẫu, giá trị nhỏ nhất, lớn nhất, trung bình và độ lệch chuẩn của nhiều biến trong một bảng [3]. Frequencies cũng cho giá trị nhỏ nhất và lớn nhất [2].
Bạn đặt kết quả cạnh bảng ngưỡng ở trên. Ví dụ của tôi tìm ra bốn dòng:
- BM092, tuổi 520. Vượt ngưỡng cứng. Phiếu ghi 52. Đây là lỗi gõ thừa một số 0. Sửa thành 52.
- BM041, cân nặng 620 kg. Vượt ngưỡng cứng. Phiếu ghi 62,0. Người nhập quên dấu phẩy. Sửa thành 62,0.
- BM118, tuổi 105. Vượt ngưỡng mềm. Phiếu ghi năm sinh 1921, khớp với tuổi. Đây là giá trị có thật. Giữ nguyên, gắn cờ “đã xác minh”.
- BM074, creatinine 780 µmol/L. Vượt ngưỡng mềm. Phiếu ghi bệnh thận mạn giai đoạn cuối, có phiếu xét nghiệm đính kèm. Giá trị thật. Giữ nguyên, gắn cờ.
Hai dòng đầu là lỗi, hai dòng sau là thật. Nếu bạn tự động xóa “mọi giá trị bất thường”, bạn xóa nhầm hai bệnh nhân thật mà không biết. Đây là lý do cần bước chẩn đoán. Và kiểm tra khoảng một mình thì chưa đủ, vì nó không thấy lỗi nằm trong khoảng (như 148 thành 184) [1].
Kiểm tra 2: Mã trùng
Mỗi người bệnh phải có đúng một study_id. Bạn kiểm mã có xuất hiện hai lần hay không. Trong SPSS, Data > Identify Duplicate Cases cho bạn chọn các biến để so khớp. Những dòng khớp hết các biến đã chọn được coi là trùng. Phần mềm tạo một biến mới: dòng “chính” và dòng không trùng nhận giá trị 1, dòng trùng còn lại nhận giá trị 0 [4].
Trong ví dụ, BM087 nằm ở dòng 87 và dòng 151. Đó chính là dòng thừa gây ra 151 dòng thay vì 150. Giờ bạn đừng xóa vội. Bạn so hai dòng:
- Hai dòng giống hệt nhau: nhiều khả năng phiếu bị nhập hai lần. Giữ một dòng, ghi vào nhật ký.
- Hai dòng khác nhau ở vài biến: có thể hai phiếu khác nhau bị gán nhầm cùng mã. Cũng có thể là hai lần nhập viện của một người. Bạn mở phiếu gốc ra xem, và có thể phải hỏi người thu thập.
Nhóm tác giả PLoS Medicine xếp việc trùng lặp hoặc gộp nhầm bản ghi vào nhóm lỗi phải làm sạch bằng mọi giá [1]. Trong ví dụ này, hai dòng giống hệt nhau. Giữ dòng 87, bỏ dòng 151, ghi lý do “nhập hai lần”.
Kiểm tra 3: Mâu thuẫn giữa các biến
Có những lỗi mà từng biến nhìn riêng đều hợp lý. Chỉ khi đặt hai biến cạnh nhau bạn mới thấy sai. Tài liệu quản lý dữ liệu của tôi nhận xét rằng loại kiểm tra logic này thường mạnh hơn kiểm tra khoảng.
Cách làm: bạn nghĩ ra các cặp biến “phải nhất quán”, rồi tạo biến mới hoặc bảng chéo để lọc ra những dòng vi phạm. Với số liệu lâm sàng, bạn thử các cặp sau:
- Ngày ra viện không được trước ngày nhập viện. Bạn tạo biến “số ngày nằm viện” bằng ngày ra viện trừ ngày nhập viện. Dòng nào có giá trị âm là dòng sai. Bạn tạo biến mới, không ghi đè ngày gốc.
- Người “không hút thuốc” thì số điếu mỗi ngày phải trống hoặc bằng 0.
- Người không dùng thuốc hạ huyết áp thì không có chuyện “tuân thủ điều trị”.
- Tuổi phải không thấp hơn mức tối thiểu của tiêu chuẩn chọn.
- Nam không thể có thai. Người đã tử vong không thể có tình trạng ra viện là “còn sống”.
Ví dụ của tôi tìm ra ba dòng:
- BM033: ra viện 02/04/2026, nhập viện 25/04/2026. Số ngày nằm viện bằng âm 23. Phiếu ghi ra viện 02/05/2026. Người nhập gõ nhầm tháng. Sửa.
- BM112:
smoking= 0 (không hút) nhưngcigs_per_day= 20. Phiếu ghi “đang hút, 20 điếu mỗi ngày”. Ôsmokingbị nhập sai. Sửa thành 2. - BM058:
n_bp_drugs= 0 nhưngadherence= 1. Phiếu để trống ô số thuốc. Không ai xác minh được người này dùng mấy thuốc. Bạn đặtn_bp_drugsthành 999, gắn cờ “không xác minh được”, và ghi vào nhật ký. Bạn không đoán là 1 hay 2.
Kiểm tra 4: Mã lạ và mã thiếu
Với biến phân loại, bạn chạy bảng tần số (Frequencies) để xem mỗi biến có những giá trị nào, mỗi giá trị bao nhiêu dòng [2]. Bạn đặt kết quả cạnh codebook. Giá trị nào không có trong codebook là mã lạ.
Ví dụ biến sex, codebook cho phép 1, 2 và mã thiếu 99:
sex |
Số dòng |
|---|---|
| 1 (nam) | 68 |
| 2 (nữ) | 79 |
| 7 | 1 |
| 99 | 2 |
| Tổng | 150 |
Mã 7 là mã lạ (BM129). Phiếu khoanh “nữ”. Sửa thành 2. Hai dòng 99 là thiếu giới tính. Nhóm tác giả PLoS Medicine liệt kê thiếu hoặc sai giới tính vào nhóm lỗi phải làm sạch bằng mọi giá [1]. Bạn quay lại hồ sơ bệnh án để tìm.
Cũng bằng Frequencies, bạn bắt được lỗi chữ viết. Biến province có thể hiện ba dòng riêng: “Hà Nội”, “Ha Noi”, “HN”. Với máy, đó là ba tỉnh khác nhau. Bạn gộp thành một mã. Tốt hơn nữa là bạn ngăn từ lúc nhập, bằng danh sách thả xuống.
Mã thiếu thì sao? Đây là chỗ nhiều người dính bẫy. Bạn dùng mã 999 cho tuổi thiếu, nhưng quên khai báo, nên phần mềm tính 999 như tuổi thật. Giả sử 4 người thiếu tuổi (mã 999) và 146 người còn lại có tuổi trung bình 60. Tuổi trung bình cả bộ sẽ là (146 × 60 + 4 × 999) / 150 = 85,04 (tự tính). Tuổi trung bình 85 ở nghiên cứu tăng huyết áp thì vô lý, nên bạn kịp nhận ra. Có trường hợp con số vẫn trông hợp lý, và bạn không nhận ra.
Cách làm đúng: các giá trị thiếu không phải thiếu của hệ thống thì phải khai báo là giá trị thiếu do người dùng định nghĩa (user-missing) [5]. Nhóm PLoS Medicine cũng viết rằng mã thay cho giá trị thiếu phải được xử lý trước khi phân tích [1]. Bạn khai báo 97, 98, 99 và 997, 998, 999 là giá trị thiếu cho từng biến, ngay trước khi chạy bất cứ thứ gì. Đừng dùng 9999 hay ngày giả như 99/99/9999.
Kiểm tra 5: Phân bố bất thường
Có những lỗi không nằm ở một con số, mà nằm ở hình dạng của cả cột số. Bạn vẽ biểu đồ cột (histogram) hoặc biểu đồ hộp (boxplot) cho từng biến định lượng. Bạn tìm ba dấu hiệu.
Hai đỉnh. Một biến lẽ ra có một đỉnh, nhưng biểu đồ có hai. Nguyên nhân hay gặp là hai đơn vị đo bị trộn. Trong ví dụ, creatinine của hầu hết phiếu nằm ở 60 đến 120 (µmol/L). Nhưng 9 phiếu từ một khoa lại nằm ở 0,8 đến 1,4, vì khoa đó ghi theo mg/dL. Bạn đổi về cùng một đơn vị theo hệ số quy đổi trong codebook, rồi ghi vào nhật ký. Vì vậy codebook nên ghi đơn vị cho mọi biến định lượng.
Số liệu dồn về vài giá trị. Hay gặp ở huyết áp. Người đo thích làm tròn. Một nghiên cứu ở New Zealand cho thấy khoảng 32% các giá trị huyết áp tâm thu tận cùng bằng số 0. Nếu ghi đến số chẵn gần nhất, mỗi chữ số chẵn đáng ra chỉ chiếm khoảng 20% [6]. Nhóm tác giả cho rằng việc làm tròn này làm một số người bị xếp nhầm mức nguy cơ tim mạch [6]. Trong ví dụ của tôi, 62 trong 150 giá trị sbp tận cùng bằng 0, tức 41% (62/150, tự tính). Bạn không sửa được những số này, vì phiếu gốc cũng đã ghi tròn. Nhưng bạn biết nó có tồn tại, và bạn viết vào phần hạn chế của bài báo.
Điểm nằm xa. Boxplot đánh dấu những điểm xa hẳn phần còn lại. Mỗi điểm bạn kiểm phiếu, xác định lỗi hay thật như ở kiểm tra 1, rồi mới quyết định.
Kiểm tra 6: Thiếu hàng loạt
Kiểm tra cuối: bạn đếm thiếu bao nhiêu, thiếu ở đâu. Bạn chạy Frequencies cho từng biến và đếm các mã thiếu [2]. Nhưng đừng chỉ đếm tổng. Bạn đếm theo nơi thu thập, theo người thu thập, theo thời gian.
Ví dụ của tôi: 38 phiếu thiếu creatinine (mã 997), tức 25,3% (38/150, tự tính). Nhìn theo khoa, 31 trong 38 phiếu đến từ Khoa Nội B. Khoa này không làm xét nghiệm creatinine thường quy cho bệnh nhân tăng huyết áp. Đây không phải lỗi nhập liệu. Đây là đặc điểm của cách chăm sóc bệnh nhân ở đó. Nó ảnh hưởng đến cách bạn phân tích và cách bạn viết bài.
Có hai điều bạn cần nhớ.
- Thiếu có nhiều lý do, và các lý do không tương đương: người bệnh không trả lời, không làm xét nghiệm, mất theo dõi, câu hỏi không áp dụng, máy hỏng. Vì vậy bạn dùng nhiều mã thiếu khác nhau thay vì một.
- Làm sạch chỉ ghi nhận và gắn mã. Bạn không điền bù ở bước này. Chỉ phân tích những người đủ số liệu có thể cho kết quả lệch. Điền bù nhiều lần (multiple imputation) thì chỉ phù hợp khi giả định đúng, và bạn không thể phân biệt thiếu “ngẫu nhiên có điều kiện” với thiếu “không ngẫu nhiên” chỉ bằng số liệu quan sát được [7]. Chọn cách xử lý là việc của bước phân tích, nên bạn bàn với thống kê viên.
Gặp một giá trị lạ, bạn làm gì
Sáu kiểm tra cho bạn một danh sách giá trị lạ. Với mỗi giá trị, bạn đi theo cùng một đường:
- Xem phiếu gốc (và hồ sơ bệnh án, nếu số liệu lấy từ đó).
- Hỏi người thu thập, nếu phiếu không rõ.
- Chọn một trong ba ngả:
| Kết luận | Việc làm | Ví dụ trong bài |
|---|---|---|
| Lỗi, tìm được giá trị đúng | Sửa, ghi nhật ký | BM092: 520 thành 52 |
| Giá trị thật, chỉ hiếm | Giữ nguyên, gắn cờ “đã xác minh” | BM074: creatinine 780 |
| Không xác minh được | Đặt mã thiếu, gắn cờ, ghi lý do | BM058: số thuốc, 999 |
Bảng không có dòng “xóa cả người bệnh vì có số lạ”. Một người sai một biến vẫn còn nhiều biến khác dùng được. Bạn chỉ loại cả người bệnh khi có quy tắc loại đã ghi trong đề cương, ví dụ vi phạm tiêu chuẩn chọn.
Với giá trị thật nhưng cực đoan, một số tác giả khuyên luôn giữ trong phân tích. Nhóm PLoS Medicine ghi nhận lời khuyên đó, đồng thời nói có nhiều ngoại lệ [1]. Cách an toàn là phân tích hai lần, có và không có các giá trị này, rồi xem kết luận có đổi không.
Nhật ký làm sạch
Nhật ký làm sạch (data cleaning log) là bảng ghi lại từng thay đổi. Mỗi dòng trả lời năm câu: sửa ở đâu, trước là gì, sau là gì, vì sao, ai sửa lúc nào. Tôi gợi ý các cột sau. Đây là mẫu tôi đề xuất dựa trên các mục mà nhóm PLoS Medicine yêu cầu [1], không phải mẫu bắt buộc.
| STT | Mã | Biến | Giá trị cũ | Giá trị mới | Lý do và nguồn | Người, ngày |
|---|---|---|---|---|---|---|
| 1 | BM092 | age_years |
520 | 52 | Gõ thừa số 0; theo phiếu giấy | Lan, 05/10/2026 |
| 2 | BM041 | weight_kg |
620 | 62,0 | Thiếu dấu phẩy; theo phiếu giấy | Lan, 05/10/2026 |
| 3 | BM087 | cả dòng | dòng 87 và dòng 151 | giữ dòng 87 | Nhập hai lần, hai dòng giống hệt | Lan, 05/10/2026 |
| 4 | BM033 | date_dis |
02/04/2026 | 02/05/2026 | Nhầm tháng; theo phiếu giấy | Hùng, 06/10/2026 |
| 5 | BM058 | n_bp_drugs |
0 | 999 | Phiếu để trống, không xác minh được; gắn cờ | Hùng, 06/10/2026 |
Ba lời khuyên khi dùng nhật ký:
- Ghi luôn, đừng để cuối tuần mới ghi. Ghi sau thì quên lý do.
- Giá trị đã xác minh là thật cũng đáng một dòng. BM118 (tuổi 105) và BM074 (creatinine 780) không cần sửa, nhưng bạn ghi “đã kiểm, giữ nguyên” để sau này không ai hỏi lại.
- Phần mềm tự ghi dấu vết sửa (audit trail) đầy đủ thì bạn không cần chép tay các sửa nhỏ. Quyết định quan trọng thì vẫn cần hồ sơ rõ ràng.
Bạn cũng nên làm sạch bằng tệp lệnh (syntax trong SPSS, script trong R, Stata) và lưu lại. Khi đó người khác chạy từ file gốc sẽ ra đúng file đã làm sạch. Bạn sửa bằng chuột trực tiếp trong bảng thì càng cần nhật ký kỹ.
Làm sao chứng minh bạn không “sửa cho đẹp”
Đây là câu hỏi của người phản biện, và cũng là câu bạn nên tự hỏi mình. Bạn trả lời bằng năm việc cụ thể:
- Đặt ngưỡng và quy tắc trước. Ngưỡng cứng, ngưỡng mềm và cách xử lý ghi trong codebook hoặc kế hoạch làm sạch, trước khi bạn nhìn số liệu.
- Hỏi đúng câu. Bạn hỏi “giá trị này có đúng với phiếu gốc và với logic của nghiên cứu không”. Bạn không hỏi “giá trị này có làm kết quả đẹp không”.
- Mỗi thay đổi có phiếu gốc làm chứng. Nhìn vào nhật ký, người ngoài tìm lại được từng dòng.
- Báo cáo. Nhóm PLoS Medicine đề nghị báo cáo các loại lỗi và tỷ lệ lỗi, ít nhất cho biến kết cục chính, kèm tỷ lệ sửa và xóa [1]. Ví dụ: “Trong 150 phiếu, có 12 giá trị được sửa theo phiếu gốc, 2 giá trị cực đoan được giữ sau khi xác minh, 1 giá trị đặt thành thiếu vì không xác minh được” (số giả định).
- Phân tích độ nhạy. Với những giá trị cực đoan còn lại, bạn chạy phân tích có và không có chúng, và nói rõ kết luận có đổi hay không [1].
Thêm một việc nữa: làm sạch xong thì đóng băng một phiên bản, ví dụ analysis_dataset_v1. Bạn không sửa lẻ tẻ trong lúc phân tích. Phát hiện lỗi muộn thì bạn mở khóa theo quy trình, sửa, ghi nhật ký, và tạo bản v2. Nhờ vậy bạn trả lời được câu “kết quả trong bài báo ứng với bản số liệu nào”.
Đã xong khi
Bước làm sạch xong khi bạn có một bộ số liệu sẵn sàng phân tích và một nhật ký đủ để người khác kiểm lại. Bạn tự soát nhé:
- Bạn đã giữ nguyên file gốc, làm trên một bản sao có tên phiên bản (ví dụ
clean_v1). - Bạn đã đặt ngưỡng cứng, ngưỡng mềm cho các biến số chính, trước khi xem kết quả.
- Bạn đã chạy đủ 6 kiểm tra: ngoài khoảng, trùng mã, mâu thuẫn giữa biến (có kiểm ngày), mã lạ và mã thiếu, phân bố, thiếu hàng loạt.
- Mỗi giá trị lạ đã được đối chiếu phiếu gốc và xếp vào một trong ba ngả: sửa, giữ có cờ, đặt thiếu.
- Các mã thiếu (97, 98, 99; 997, 998, 999) đã được khai báo là giá trị thiếu trong phần mềm.
- Mỗi thay đổi có một dòng nhật ký: mã, biến, giá trị cũ, giá trị mới, lý do, người, ngày.
- Bạn đã đóng băng một phiên bản số liệu để phân tích, và ghi tên phiên bản đó vào kế hoạch phân tích.
Nhớ ba điều là đủ
Thứ nhất, bạn phát hiện, chẩn đoán rồi mới sửa. Không nhảy thẳng sang xóa. Thứ hai, bạn sửa theo phiếu gốc, giữ file gốc nguyên vẹn, và không đoán khi không xác minh được. Thứ ba, mọi thay đổi để lại một dòng nhật ký, nhờ đó bạn chứng minh được mình không sửa cho đẹp.
Nếu bạn muốn thực hành từng bước trên phần mềm, tôi có khóa học về kiểm tra dữ liệu và quản lý số liệu. Bạn cũng có thể bắt đầu với khóa Nhập môn phân tích số liệu với SPSS, miễn phí. Bạn xem ở mục Khóa học.
Đọc tiếp
Trước bước này là phiếu thu thập số liệu, codebook và nhập liệu nghiên cứu y học. Sau làm sạch là phân tích số liệu.